Для ИИ-вычислений больше не нужны крупные дата-центры — новая эпоха AI-инфраструктуры
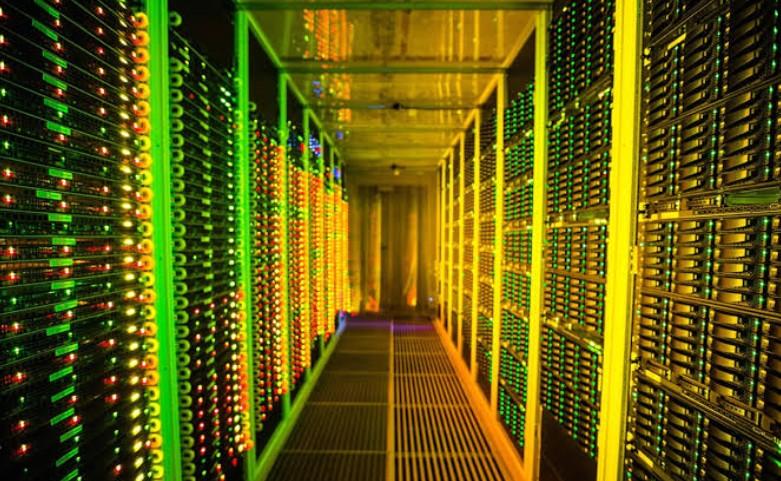
Еще недавно развитие искусственного интеллекта практически ассоциировалось с гигантскими дата-центрами, тысячами графических процессоров и огромным потреблением электроэнергии. Обучение крупных языковых моделей действительно требует колоссальных вычислительных ресурсов. Однако по мере распространения ИИ меняется сама структура вычислительной нагрузки.
Сегодня все больше внимания уделяется распределенным ИИ-вычислениям, edge computing и небольшим модульным дата-центрам. Вместо того чтобы отправлять каждый запрос пользователя в несколько крупнейших мировых вычислительных кластеров, часть задач можно выполнять ближе к источнику данных — в региональном дата-центре, на предприятии, в телекоммуникационной сети или непосредственно на устройстве.
Это не означает, что большие дата-центры станут ненужными. Они по-прежнему критически важны для обучения наиболее крупных моделей. Но для повседневного использования искусственного интеллекта архитектура постепенно становится более гибкой.
Почему эпоха гигантских дата-центров меняется
Главное различие заключается между обучением ИИ-модели и инференсом.
На этапе обучения нейросеть обрабатывает огромные массивы данных и многократно изменяет миллиарды параметров. Для этого нужны тесно связанные между собой GPU, высокая пропускная способность памяти и сверхбыстрые соединения между вычислительными узлами. Распределить такую нагрузку по множеству удаленных небольших площадок крайне сложно.
Совсем иначе выглядит инференс — использование уже обученной модели для генерации ответа, анализа изображения, обработки видео или выполнения команды. Здесь вычислительная нагрузка может быть значительно более локальной.
Именно поэтому AI inference становится одним из главных драйверов перехода к распределенной инфраструктуре. По оценке Deloitte, в 2026 году инференс может составлять около двух третей всех ИИ-вычислений, однако значительная их часть все еще будет выполняться на мощных ускорителях в крупных дата-центрах.
Таким образом, правильнее говорить не о конце больших дата-центров, а о появлении многоуровневой инфраструктуры ИИ.
Что такое распределенные ИИ-вычисления
Распределенные ИИ-вычисления предполагают, что вычислительные мощности находятся не в одной точке, а распределены между несколькими уровнями.
Это могут быть:
крупные облачные дата-центры;
региональные вычислительные площадки;
небольшие модульные дата-центры;
серверы на предприятиях;
телекоммуникационные узлы;
edge-серверы;
персональные компьютеры и рабочие станции;
смартфоны и другие устройства с AI-ускорителями.
Такая архитектура позволяет выбирать место выполнения задачи в зависимости от ее требований. Большая модель может обрабатываться в облаке, тогда как компактная модель для анализа изображения с камеры — непосредственно рядом с камерой.
Исследования в области edge AI показывают, что перенос вычислений ближе к источнику данных позволяет уменьшать задержки, объем передаваемых данных и зависимость от централизованного облака.
Небольшой дата-центр вместо огромного комплекса
Одним из наиболее заметных направлений становится развитие модульных дата-центров.
Вместо строительства гигантского объекта на несколько лет можно использовать компактный вычислительный блок, оборудованный GPU или специализированными AI-ускорителями. Такой блок потенциально можно разместить там, где уже есть доступная электроэнергия, сетевое подключение и необходимая инфраструктура охлаждения.
Показательный пример появился в 2026 году: компания Crusoe, известная строительством крупных AI-инфраструктурных объектов, начала развивать небольшие модульные дата-центры Spark. Их концепция предполагает производство вычислительных блоков на специализированных площадках и последующее размещение там, где доступна необходимая энергетическая инфраструктура. При этом компания продолжает работать и с крупными дата-центрами.
Получается своеобразный переход от модели «построить один огромный вычислительный завод» к модели «разместить вычисления там, где они нужны».
Почему вычисления выгодно переносить ближе к пользователю
Главное преимущество edge AI — снижение задержки.
Представим промышленного робота, систему видеонаблюдения или автономную машину. Если каждый видеокадр необходимо отправлять в удаленный дата-центр, ждать обработки и получать результат обратно, сетевые задержки могут стать критическими.
При локальной обработке часть вычислений выполняется непосредственно рядом с устройством.
Это особенно важно для:
автономного транспорта;
промышленной автоматизации;
робототехники;
систем безопасности;
медицинских устройств;
умных городов;
анализа видео в реальном времени;
голосовых ассистентов;
интерактивных приложений и игр.
В 2026 году NVIDIA, например, представила концепцию AI Grid — распределенной вычислительной инфраструктуры, использующей телекоммуникационные сети для размещения AI-нагрузок ближе к конечным пользователям. В отдельных сценариях такие сети могут объединять большое количество edge-площадок.
ИИ постепенно становится частью телекоммуникационной инфраструктуры
Еще один важный тренд — объединение вычислений и сетей.
Телекоммуникационные операторы располагают большим количеством узлов, расположенных значительно ближе к пользователям, чем традиционные hyperscale-дата-центры. Если разместить там GPU или специализированные ускорители, сеть может одновременно обеспечивать передачу данных и выполнение ИИ-задач.
В марте 2026 года NTT и DOCOMO сообщили о демонстрации технологии, которая позволяет подключать распределенные GPU к 5G-сети и управлять обработкой AI-задач непосредственно на уровне сети. В эксперименте технология использовалась для низколатентного анализа видео.
Это открывает путь к новой архитектуре, в которой ИИ становится не отдельным облачным сервисом, а частью цифровой инфраструктуры.
Специализированные чипы снижают требования к инфраструктуре
Еще одна причина изменений — развитие специализированного оборудования.
Для запуска ИИ-модели далеко не всегда необходим самый мощный GPU, который используется для обучения передовых моделей. Для инференса могут применяться энергоэффективные ускорители, NPU, специализированные AI-чипы и GPU меньшей мощности.
Производители оборудования уже адаптируют архитектуры под эту задачу. Например, Intel в 2026 году представила решения, ориентированные на разные уровни AI-нагрузки — от серверных систем до edge-устройств. Отдельный акцент сделан на эффективном инференсе и возможности выполнять AI-задачи в существующей инфраструктуре.
Одновременно развивается сотрудничество между несколькими устройствами. Если ресурсов одного edge-узла недостаточно, задача может быть распределена между несколькими серверами.
Таким образом формируется вычислительный континуум: от смартфона и локального компьютера до небольшого дата-центра и огромного AI-кластера.
Экономика становится не менее важной, чем производительность
Еще один фактор — стоимость.
Строительство крупного дата-центра требует огромных инвестиций, времени, электроэнергии, систем охлаждения и подходящей площадки. Кроме того, во многих регионах доступ к электрическим сетям становится ограничивающим фактором.
Небольшие вычислительные площадки позволяют распределять инвестиции и быстрее наращивать мощности. При необходимости компания может установить дополнительный модуль, а не полностью перестраивать существующий объект.
Распределенная архитектура также позволяет размещать вычисления рядом с доступными источниками энергии.
По мнению аналитиков, энергетические ограничения становятся одним из факторов, которые стимулируют развитие распределенной инфраструктуры ИИ.
А что будет с большими дата-центрами?
Несмотря на развитие edge computing, говорить об исчезновении крупных дата-центров преждевременно.
Для обучения передовых моделей по-прежнему нужны огромные кластеры с большим количеством ускорителей и высокоскоростными соединениями. Например, обучение модели Meta Llama 3.1 405B потребовало около 16 000 GPU, причем оборудование должно было работать в тесно связанной конфигурации.
Кроме того, крупные дата-центры могут эффективно обслуживать огромные объемы запросов, централизованно управлять моделями и обеспечивать необходимую инфраструктуру хранения данных.
Поэтому в будущем, скорее всего, будут сосуществовать две модели.
Крупные AI-дата-центры будут заниматься обучением моделей, масштабным инференсом и задачами, требующими огромной концентрации вычислительных ресурсов.
Небольшие и распределенные площадки будут брать на себя локальный инференс, обработку данных в реальном времени и задачи, для которых критичны задержка, стоимость передачи данных или конфиденциальность.
Главный тренд — не отказ от дата-центров, а их децентрализация
Искусственный интеллект вступает в новый этап развития. Если первоначальная гонка была сосредоточена на создании максимально мощных вычислительных кластеров, то теперь на первый план выходит вопрос эффективности: где именно должна выполняться конкретная AI-задача?
Ответ не всегда будет звучать как «в крупнейшем дата-центре».
Часть вычислений переместится на устройства, часть — в локальные серверы, часть — в небольшие модульные дата-центры, а самые тяжелые задачи останутся в крупных AI-кластерах.
Именно такая комбинация может стать основой следующего поколения AI-инфраструктуры.
Поэтому заголовок «для ИИ больше не нужны крупные дата-центры» стоит понимать не буквально. Крупные дата-центры не исчезают — исчезает их монополия на выполнение всех ИИ-задач.
Будущее искусственного интеллекта, вероятно, будет построено вокруг распределенной системы, в которой вычислительная мощность находится максимально близко к месту, где она действительно нужна. Это позволит одновременно сокращать задержки, оптимизировать расходы на инфраструктуру и эффективнее использовать доступную электроэнергию.
Именно переход от единого гигантского центра к сети из больших, средних и малых вычислительных узлов становится одним из ключевых изменений современной AI-инфраструктуры.